A IA generativa impressiona, mas decisões exigem outra coisa
Por que decisões críticas continuam sendo probabilísticas e não generativas
Enquanto modelos generativos dominam as manchetes com textos, imagens e código, outro tipo de algoritmo segue operando longe do hype, mas no centro das decisões mais críticas do mundo digital.
Ele não cria conteúdo. Ele decide.
Essa diferença é menos óbvia do que parece e muito mais importante.
Modelos generativos são treinados para produzir respostas, já os discriminativos são treinados para estimar risco e probabilidade. São eles que aprovam crédito, liberam transações, classificam fraude e decidem se alguém deve ou não agir.
Entre esses modelos, um se destaca pela longevidade e pela presença silenciosa em sistemas críticos: a regressão logística.
Há mais de 60 anos ela responde à pergunta que realmente move decisões executivas: qual é a probabilidade de isso acontecer?
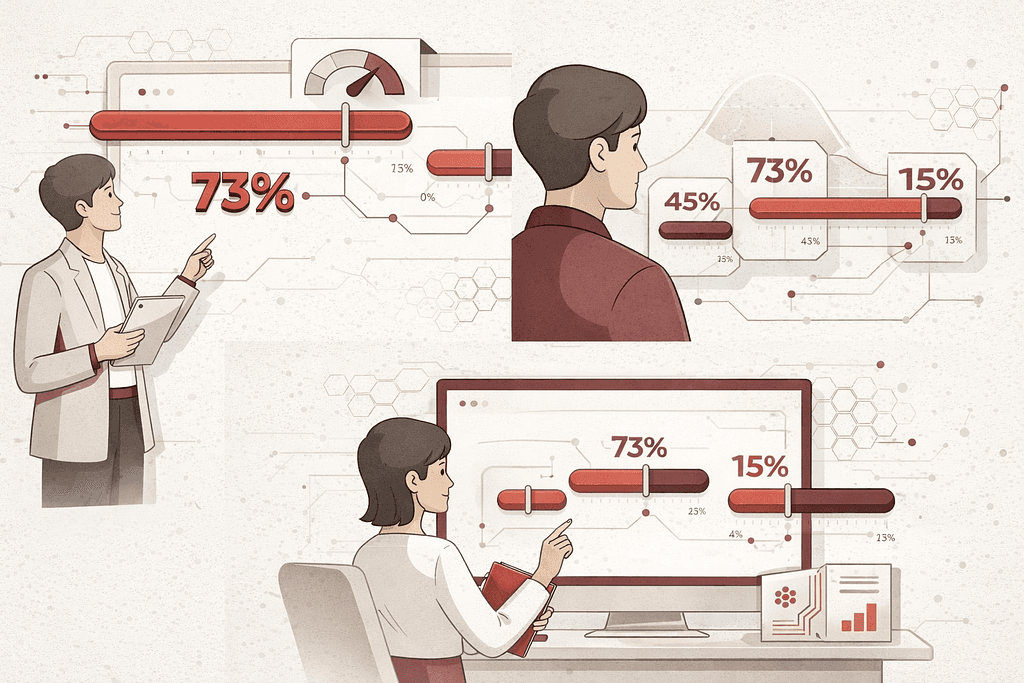
Ela não entrega um “sim” ou “não”. Entrega algo mais útil: 73%, 28%, 91%. Probabilidades que permitem decisões graduais, proporcionais e defensáveis.
É por isso que continua no centro dos sistemas de PayPal, Stripe, Nubank, QuintoAndar e instituições financeiras no mundo todo.
Não por nostalgia, mas por pura estratégia.
Durante muito tempo, decisões críticas foram tomadas com regras fixas.
Se o cliente não acessou em 30 dias, está em risco. Se a transação é internacional e acima de um valor arbitrário, bloqueia. Se o lead abriu alguns e-mails, é considerado quente.
O problema é simples: regras tratam casos diferentes como se fossem iguais.
Dois clientes podem ficar inativos pelo mesmo período por motivos completamente opostos. Um está abandonando o produto. O outro está apenas ausente. A regressão logística resolve isso transformando decisões binárias em gradientes de risco.
Ela não pergunta se alguém vai cancelar e sim com que probabilidade isso acontece.
Quando o risco é alto, há intervenção humana. Quando é médio, automação. Quando é baixo, o fluxo segue normalmente.
Essa transição de decisões absolutas para decisões baseadas em probabilidade é o que separa automação ingênua de decisão madura.
A força da regressão logística está justamente no fato de que ela funciona sem mágica.
A partir de dados históricos, o modelo aprende quais fatores aumentam ou reduzem a chance de um evento acontecer. Cada fator recebe um peso. A combinação desses pesos vira uma estimativa clara, estável e auditável.
E isso muda tudo quando explicar decisões deixa de ser opcional.
Regulações como o EU AI Act exigem explicações claras para decisões automatizadas em crédito, saúde e emprego. Leis semelhantes já existem em outros mercados. Em muitos contextos, não basta decidir corretamente, é preciso explicar por que aquela decisão foi tomada.
Modelos interpretáveis permitem isso por construção. Reguladores entendem. Auditores validam. Times internos conseguem sustentar decisões difíceis.
Não é coincidência que, depois de anos apostando apenas em complexidade, muitas empresas estejam voltando a modelos interpretáveis. Isso não é retrocesso, mas sim maturidade.
Nos bastidores, a regressão logística continua dominante.
Em pagamentos, decisões precisam acontecer em milissegundos. No PayPal e no Stripe, modelos lineares sempre foram a primeira escolha para detecção de fraude justamente por isso.
No Brasil, o Nubank construiu boa parte da sua operação de crédito sobre modelos interpretáveis. Escalar crédito para milhões de pessoas exige modelos que toda a organização consiga entender, ajustar e defender. O QuintoAndar segue a mesma lógica ao classificar risco de inquilinos e proprietários.
Na saúde, explicar não é formalidade. É condição para ação. Programas como os do Medicare utilizam regressão logística para prever reinternações porque médicos precisam entender por que um paciente é considerado de alto risco.
Até em vendas e marketing, plataformas como a HubSpot utilizam regressão logística como base para lead scoring quando entender o porquê de uma decisão é tão importante quanto o score em si.
Quando impacto, escala e governança entram em jogo, modelos simples vencem.
Existem algoritmos mais sofisticados? Claro.
Eles capturam relações mais complexas e, em testes, costumam apresentar métricas ligeiramente melhores. O ponto é que esse ganho raramente muda decisões reais.
Na prática, modelos mais complexos acabam tomando quase as mesmas decisões, mas com mais custo, menos clareza e mais dificuldade de governança.
É exatamente aí que a maturidade analítica aparece.
Empresas maduras não perguntam qual modelo é mais sofisticado. Perguntam qual modelo equilibra performance, explicabilidade, velocidade e custo de manutenção para aquela decisão específica.
O iFood segue essa lógica. Usa modelos complexos quando a personalização em escala justifica a complexidade, mas mantém modelos simples onde rastreabilidade e governança são essenciais.
A sofisticação não está em usar o modelo mais avançado, mas em saber qual modelo usar em qual contexto.
A IA generativa impressiona, mas as decisões que movem dinheiro, risco e confiança continuam sendo tomadas por outro tipo de modelo.
Talvez a pergunta não seja se a regressão logística ainda é relevante.
Talvez seja esta: em quantos processos críticos você ainda decide em “sim ou não” quando poderia operar com probabilidades?
No fim, vantagem competitiva não vem da técnica mais nova, mas da técnica certa, aplicada com disciplina e explicação.