O dia em que as máquinas aprenderam a ligar café a espresso
O termo NLP, ou Natural Language Processing, aparece em relatórios de mercado e apresentações há anos, no entanto, quase sempre fica perdido na névoa das buzzwords. Mas, afinal, o que ela significa para um gestor?
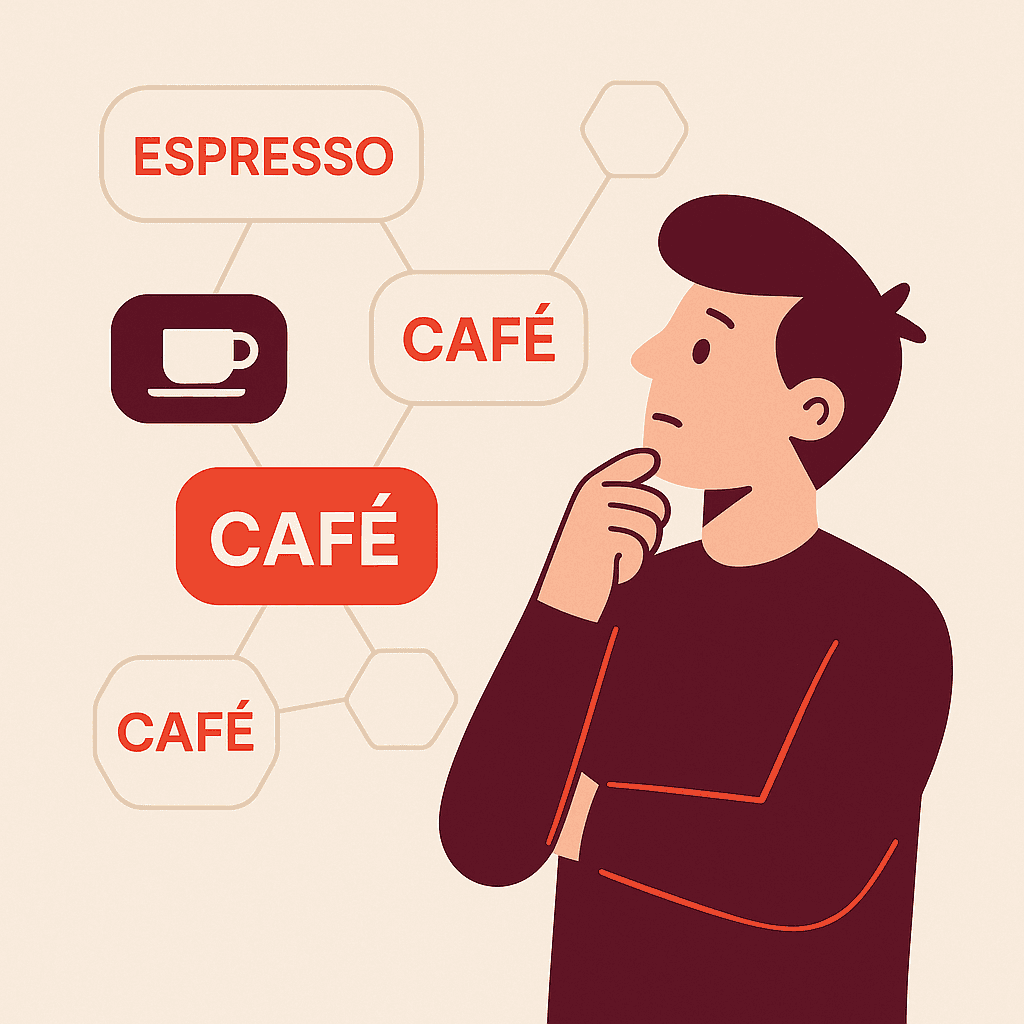
Na prática, NLP é o que permite ao Instagram sugerir hashtags certeiras, ao Slack indicar canais relevantes ou ao seu e-commerce preferido recomendar os produtos que o cliente nem sabia que queria. É a tecnologia que ensina máquinas a entenderem que "café" e "espresso" pertencem ao mesmo universo semântico, enquanto a bebida e o estabelecimento com mesmo nome "café", habitam mundos distintos.
Sair da simples análise de palavras isoladas para a compreensão de significados e relações entre as palavras não aconteceu do dia pra noite. Esse salto começou com técnicas estatísticas simples, como o TF-IDF, e evoluiu para os embeddings, que mapeam ideias em coordenadas matemáticas.
TF-IDF: o início da busca por palavras
TF-IDF (Term Frequency-Inverse Document Frequency) foi, durante décadas, o estado da arte em sistemas de busca corporativos. Ainda hoje, roda em milhares de intranets e bases de conhecimento.
- TF mede quantas vezes uma palavra aparece em um documento;
- IDF ajusta esse valor conforme a raridade da palavra no conjunto total de documentos.
Palavras comuns, como "o" ou "de", recebem pouco peso. Palavras mais específicas, como "maratona" ou "espresso", ganham destaque por diferenciar conteúdos.
Isso gera vetores longos e esparsos, formados predominantemente por zeros, que possibilitaram a criação dos primeiros buscadores eficientes. Porém, seu calcanhar de Aquiles é evidente: o TF-IDF não compreende contexto, sinônimos ou nuances. Para esse método, "correr" e "maratona" não possuem qualquer relação semântica. Essa limitação pavimentou o caminho para os embeddings.
Embeddings: o salto para o significado
Embeddings representam palavras, frases ou documentos como vetores densos, com centenas de dimensões, em um espaço multidimensional de significados. Diferente do TF-IDF, onde cada dimensão é uma palavra, nos embeddings cada dimensão carrega os traços do contexto.
Nesse espaço, "correr", "maratona", "endurance" aparecem próximos uns dos outros, enquando "correr" e "geladeira" ficam distantes. É como um GPS semântico em que cada conceito tem coordenadas, e vizinhos de significado aparecem próximos uns dos outros.
Se o TF-IDF conta as palavras, embeddings constroem um mapa de significados. Essa diferença é o que permite recomendar produtos ou sugerir hashtags mesmo quando não existem palavras em comum.
Como a máquina mede proximidade
Quando transformamos textos em vetores, a comparação deixa de ser textual e passa a ser geométrica. Duas ideias podem estar próximas porque seguem na mesma direção ou porque estão literalmente coladas no espaço de representações.
A métrica mais usada é a similaridade de cossenos, que mede o ângulo entre dois vetores. Se eles apontam para o mesmo sentido, a similaridade se aproxima de 1; se estão em direções ortogonais (transversais), ela se aproxima de 0. Isso significa que mesmo textos diferentes em tamanho podem ser considerados próximos se "apontam" para o mesmo conceito.
Veja um exemplo:
- Documento A: “Estratégias de marketing digital para startups”
- Documento B: “Táticas de growth hacking para empresas iniciantes”
- Documento C: “Receita de bolo de chocolate”
Mesmo sem apresentarem palavras idênticas, os documentos A e B teriam similaridade de cosseno próxima de 0,85, bastante alta, pois estão alinhados no espaço semântico. Já A e C ficariam em torno de 0,15, mostrando que pertencem a universos completamente diferentes.
Outra métrica é a distância euclidiana, que mede a distância reta entre os pontos. Quanto menor a distância, mais próximos os vetores. A diferença é que a euclidiana também leva em conta o módulo (o tamanho do vetor), o que em alguns contextos pode ser útil.
Existe até uma relação prática: quando normalizamos os vetores para terem comprimento igual a 1, procedimento comum em embeddings, minimizar a distância euclidiana é equivalente a maximizar o cosseno. Em outras palavras: se o foco é a semântica, normaliza-se o vetor e usa-se cosseno (ou produto interno, para os mais familiares com Álgebra Linear); caso o tamanho carregue informação relevante, a euclidiana preserva essa nuance.
Ferramentas como o FAISS (do Facebook) aplicam esses cálculos em escala, permitindo responder buscas em bases com milhões de vetores em questão de milissegundos.
Do conceito ao valor no DRE
Embeddings não são apenas inovação, já estão gerando resultados concretos e mensuráveis em operações empresariais:
Suporte ao Cliente
10% dos tickets resolvidos automaticamente
O Dollar Shave Club, durante o early access do Answer Bot da Zendesk, conseguiu resolver em média 4.500 tickets por mês, o que equivale a 10% de redução no volume total de tickets com intervenção humana.
Fonte: Zendesk Blog — Introducing Answer Bot
Due Diligence Jurídico
Até 40% de redução no tempo de revisão
A Cognia Law obteve uma redução de 40% no tempo de revisão contratual, com aproximadamente 90% de precisão, ao usar o software da Kira Systems. Já o escritório Freshfields, também com Kira, reportou 20–40% de ganhos em eficiência nos mesmos tipos de projetos.
Fontes:
Busca Vetorial
Até 5x mais rápida com Elastic
A Elastic anunciou que seu novo algoritmo ACORN‑1 entrega buscas vetoriais até 5 vezes mais rápidas, mantendo a qualidade dos resultados — um ganho decisivo para aplicações de IA escaláveis.
Fonte: Elastic IR – Elastic Announces Faster Filtered Vector Search with ACORN‑1…
Do conceito à prática
Ferramentas modernas como LangChain e bibliotecas como FAISS tornam esse processo acessível a qualquer equipe. Para demonstrar, preparei um notebook no GitHub que mostra:
- TF-IDF como baseline comparativo;
- Embeddings densos para semântica avançada;
- Busca vetorial com FAISS via LangChain;
- Comparação direta de proximidade (cosseno e euclidiana).
Execute e veja a diferença: enquanto o TF-IDF sugere resultados por palavras em comum, embeddings sugerem por significado.
Por que gestores devem se importar
Entender a diferença entre TF-IDF e embeddings é chave para avaliar soluções de IA que prometem "entender contexto". Saber como a similaridade é calculada ajuda a:
- Avaliar fornecedores: qual técnica usam? TF-IDF, embeddings, ambos?
- Estimar ROI: em média, embeddings automatizam 20–40% de tarefas textuais.
- Priorizar casos de uso: foco em áreas de alto volume e variabilidade textual, como: suporte, documentos, comercial.
Da próxima vez que o Instagram sugerir uma hashtag certeira, lembre-se: não foi sorte, foi cálculo vetorial — às vezes pelo ângulo (cosseno), outras vezes pela distância (euclidiana).
O futuro não é mais sobre encontrar palavras, mas sobre descobrir significados. Essa mudança transforma como organizamos conhecimento, atendemos clientes e competimos no mercado.