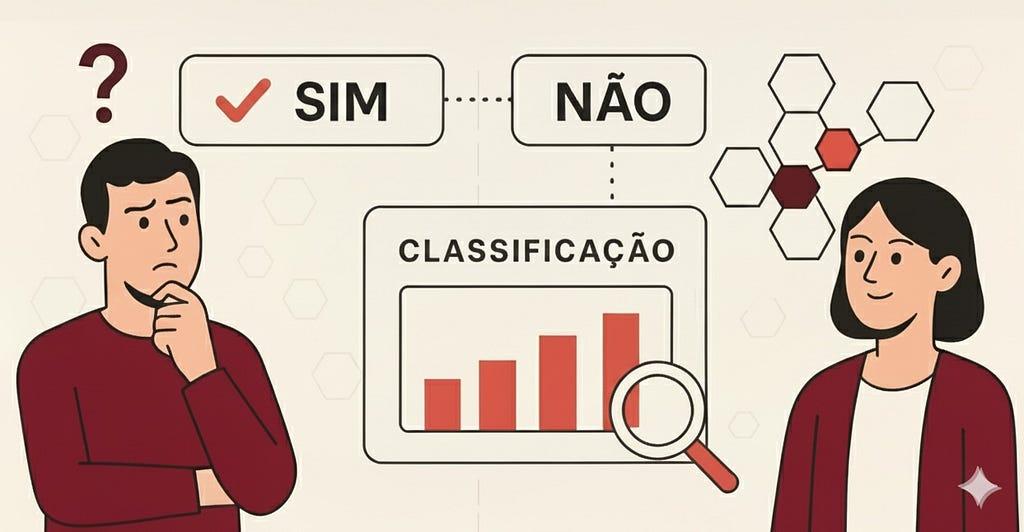
Decisões binárias não veem os tons de cinza
E é justamente aí que Netflix, iFood e Nubank nadam de braçada.
As IAs generativas são a tendência do momento, mas enquanto os holofotes iluminam os chatbots e copilotos, existe um outro tipo de inteligência artificial que há anos entrega resultados concretos em muitas das maiores empresas do mundo. Essa tecnologia não cria textos, tampouco imagens, mas organiza decisões complexas em categorias claras.
Foi justamente essa lógica que o LinkedIn incorporou ao seu sistema de recomendação de vagas. Ao aplicar técnicas de classificação multiclasse no seu fluxo de job matching, a plataforma elevou a qualidade das correspondências entre candidatos e empresas, melhorando sensivelmente as métricas de eficiência em testes A/B realizados.
O salto do binário para o multiclasse
Até recentemente, os sistemas de recomendação eram binários: mostrar ou não mostrar uma vaga para você. Porém, na vida real “sim” ou “não” raramente são a resposta. Recrutadores, médicos, analistas de risco, ou vários outros profissionais, trabalham com gradações.
Para exemplificar, na triagem hospitalar, ninguém decide apenas entre “atender agora” ou “atender depois”. Os pacientes são classificados em categorias: emergência, urgente, pouco urgente, eletivo. Com essa simples mudança de abordagem, vidas são salvas.
Já no LinkedIn, essa transformação tornou-se essencial para conectar pessoas às oportunidades certas. Hoje, cada vaga pode ser rotulada como forte, boa ou baixa correspondência com um determinado perfil. Por trás disso, está a técnica chamada de classificação multiclasse, que serve como base de diversas soluções modernas de ML (Machine Learning).
Como a técnica funciona (sem o hype, mas com resultados)
Aqui está o ponto-chave: não estamos falando de LLMs escrevendo parágrafos, mas sim de algoritmos clássicos e robustos que ainda sustentam a maior parte do ROI (Return on Investment) em aplicações de IA atualmente.
A evolução começou de forma simples, com abordagens estilo One-vs-Rest. Imagine que você precisasse classificar frutas entre maçã, banana ou laranja. Aqui você precisaria treinar três classificadores separados, cada um decidindo se uma fruta é de determinado tipo, ou não. Já na hora de “prever”, cada modelo iria fornecer uma probabilidade e escolheríamos a mais alta.
Depois vieram as árvores de decisão. Elas funcionam como “fluxogramas”, fazendo perguntas em sequência (por exemplo: “renda > 5.000?”, “idade < 30?”) até chegar em uma resposta. São intuitivas e fáceis de explicar, mas carregam a armadilha do overfitting.
Para superar esse problema, surgiram as Random Forests. Em vez de confiar no resultado de uma única árvore, várias árvores são treinadas com subconjuntos dos dados. Cada uma dá um “voto” e, no final, a maioria vence. É assim que os filtros de spam conseguem decidir se um e-mail vai para sua caixa de entrada, pra aba de promoções ou pro lixo.
O próximo avanço foi o bossting, com os métodos como o XGBoost e LightGBM. Aqui cada árvore aprende com os erros da anterior. Como resultado, tem-se um modelo que encontra padrões mais sutis e entrega precisão superior. Por isso, se tornaram a escolha padrão em competições da área e em aplicações de missão crítica, como a detecção de fraudes financeiras.
Como exemplo, o PayPal utiliza ML em tempo real para analisar milhões de transações e detectar padrões de fraude. Seus modelos automatizam decisões sem atrito para os clientes e bloqueiam centenas de milhões de dólares em tentativas fraudulentas a cada trimestre.
E, finalmente, chegamos às redes neurais, as protagonistas quando lidamos com dados complexos como imagens, áudio e texto. Pense nelas como uma sequência de filtros em camadas: cada filtro revela um aspecto diferente da informação, como formas, cores ou padrões escondidos. Ao final desse processo, a rede combina os sinais e os traduz em probabilidades — por exemplo, “80% de chance de ser positivo, 15% neutro e 5% negativo”. As CNNs (Convolutional Neural Networks, ou Redes Neurais Convolucionais) se consolidaram em visão computacional, as LSTMs (Long Short-Term Memory, ou Memória de Longo Prazo) ganharam espaço em sequências de texto e séries temporais, e os Transformers, como BERT e GPT, redefiniram o processamento de linguagem natural. Em todos esses casos, o princípio é o mesmo: transformar a complexidade em categorias claras e acionáveis, exatamente a essência da classificação multiclasse.
Mas e quando o modelo erra?
O problema mais comum é o overfitting: quando o modelo memoriza exemplos do passado e não consegue generalizar para novos casos. É como um aluno que decora todas as respostas do simulado, mas se perde na prova real.
Para evitar isso, entram em cena três técnicas fundamentais:
- Cross-validation: dividir os dados em várias partes, treinar em algumas e testar em outras, repetindo o processo em rodízio. Se o modelo se sai bem em todos os cenários, há sinais de que aprendeu de forma robusta.
- Early stopping: acompanhar o desempenho em dados de validação durante o treino. Quando o modelo começa a piorar nesses dados, interrompemos o processo — como parar um atleta no ponto certo antes que a fadiga comprometa sua performance.
- Regularização L1/L2: adicionar pequenas penalidades matemáticas durante o treino, forçando o modelo a ser mais simples e equilibrado, destacando apenas o que realmente importa, ou impedindo que uma única variável domine a decisão.
Essas técnicas raramente aparecem no discurso comercial, mas são o que dá sustentação a sistemas robustos em escala, como os do LinkedIn, da Netflix e do PayPal. Sem elas, os ganhos de precisão em laboratório dificilmente se manteriam no mundo real.
Muito além do recrutamento — e o reflexo no Brasil
A classificação multiclasse já sustenta resultados concretos em diferentes indústrias. Na Netflix, recomendações personalizadas respondem por mais de 80% das horas assistidas, mantendo o usuário engajado. O PayPal usa a mesma lógica em seus sistemas antifraude, analisando milhões de transações em tempo real para decidir se aprovar, pedir autenticação extra ou bloquear.
No Brasil, o movimento segue o mesmo caminho. O Nubank aplica modelos para segmentar riscos de crédito em múltiplas camadas, indo além do simples “aprovar ou negar”. O iFood utiliza algoritmos para recomendar pratos e otimizar entregas levando em conta urgência, perfil do consumidor e contexto logístico. O QuintoAndar melhora o matching entre inquilinos e proprietários classificando variáveis como localização, capacidade de pagamento e preferências de imóvel. Esses exemplos mostram que, tanto globalmente quanto no Brasil, a vantagem competitiva nasce quando empresas substituem decisões binárias por categorias inteligentes.
Por que agora
Enquanto o hype gira em torno da IA generativa, o mercado global de MLOps cresce aceleradamente: de cerca de US$ 1,7 bilhão em 2024 para uma projeção de US$ 39 bilhões em 2034, segundo a Global Market Insights (gminsights.com).
Esse crescimento mostra que a industrialização do machine learning já está em curso. A diferença competitiva não está em conhecer a técnica, mas em aplicá-la com disciplina.
Sua próxima decisão
Se o LinkedIn conseguiu melhorar o job matching, a Netflix manter os espectadores engajados por milhões de horas e o PayPal bloquear bilhões em tentativas de fraude, imagine o impacto que a mesma lógica pode ter nos processos críticos da sua empresa: do suporte ao crédito e da logística ao marketing.
A questão não é se você vai aplicar classificação multiclasse, mas quanto tempo de vantagem sua concorrência terá enquanto você ainda decide!